在人工智能技術飛速發展的今天,算力與算法已成為驅動創新的兩大核心引擎。其中,以智能芯片構建的人工智能計算機集群為基礎,并在此基礎上進行人工智能基礎軟件的開發,構成了支撐大規模AI應用落地的關鍵基礎設施。
一、智能芯片構建人工智能計算機集群
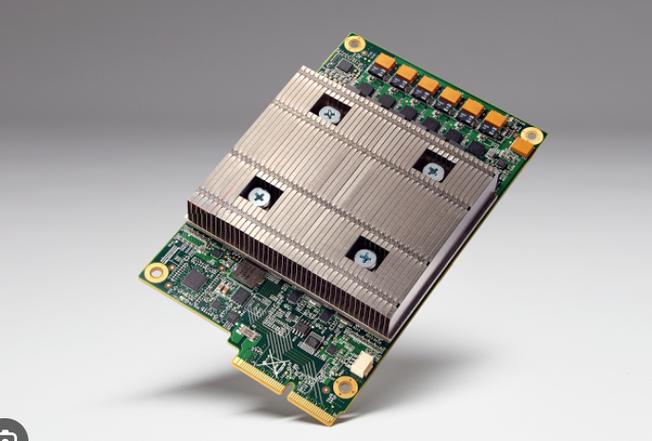
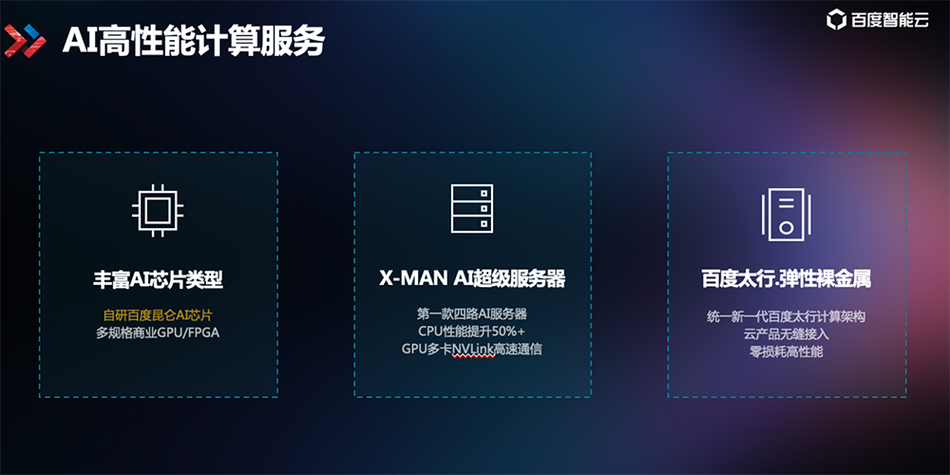
傳統的通用CPU在應對深度學習海量矩陣運算時逐漸力不從心。為此,業界轉向了專為AI計算設計的智能芯片,如GPU、TPU、NPU以及各類領域專用架構(DSA)芯片。這些芯片具備高并行度、低精度計算優化和高能效比的特點,能夠大幅加速神經網絡的訓練與推理。
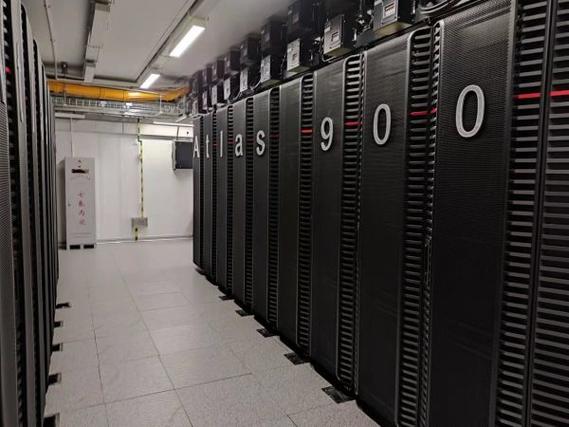
通過高速互聯技術(如NVIDIA NVLink、InfiniBand或自研網絡),成千上萬顆智能芯片被組織成大規模計算機集群。集群中的每個節點通常包含多顆智能芯片,節點間通過高速網絡實現參數同步與數據交換。這種集群架構不僅能提供艾級(ExaFLOPs)算力,還能通過分布式并行策略(數據并行、模型并行、流水線并行)支撐萬億參數級大模型的訓練。
集群的構建還需要配套的高性能存儲、冷卻系統與電力管理。張量級存儲與并行文件系統確保數據喂給芯片的速度不被瓶頸約束,液冷或風冷方案控制散熱密度,而智能調度系統則按任務優先級和資源碎片情況動態分配算力。
二、基于智能芯片集群的人工智能基礎軟件開發
有了底層的芯片集群,還需要系統化的基礎軟件來“激活”算力潛能。人工智能基礎軟件通常分為以下幾個層次:
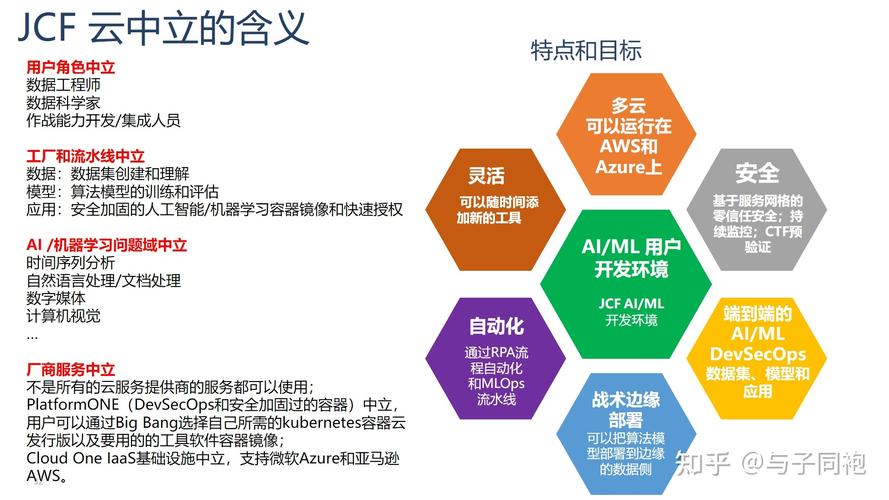
- 芯片級驅動與運行時:與智能芯片架構緊密耦合,負責指令調度、內存管理、緩存優化與芯片間通信。例如CUDA(對應NVIDIA GPU)、ROCm(對應AMD)、CANN(對應華為昇騰)等,它們向高水平框架暴露統一或領域專用的接口。
- 分布式計算框架與通信庫:解決多芯片、多節點下的并行效率問題。典型組件的代表包括NCCL(NVIDIA集合通信庫)、Gloo、OpenMPI以及各類參數服務器。它們處理All-Reduce、Broadcast等通信原語,使大模型訓練能在集群上高效擴展到數萬張芯片。
- 深度學習框架:為用戶提供構建模型的編程接口和自動微分機制,如PyTorch、TensorFlow、PaddlePaddle、MindSpore。框架需要針對智能芯片做深度適配,如圖算子融合、混合精度訓練、動態圖/靜態圖轉換,并利用集群特性實現容錯與彈性訓練。
- 模型壓縮與推理引擎:針對實際部署場景,通過量化、剪枝、知識蒸餾降低模型體積和算力開銷,同時配合推理后端(如TensorRT、OpenVINO、TNN)優化智能芯片上的執行效率,降低延遲與功耗。
- 開發工具鏈與平臺:涵蓋數據預處理、模型可視化、超參調優、自動化機器學習(AutoML)、實驗管理與部署服務,幫助團隊高效率地開發、迭代和上線AI應用。
三、協同優化的關鍵方向
硬件與基礎軟件需要無縫配合,才能實現最佳整體性能。主要的協同優化方向包括:
- 軟硬件一體的算子編譯器:利用TVM、MLIR等多層中間表達技術,使同一套算子能自動映射到不同智能芯片上,生成高效后端代碼。
- 動態編譯與運行時優化:根據輸入形狀、數據分布等功能做代碼特化,提升緩存命中率,減少內存拷貝。
- 存算一體與近存計算支持:未來智能芯片可能引入存內計算單元,基礎軟件需調整數據流調度,發揮架構創新優勢。
- 集群級彈性與容錯:通過檢查點,故障預測,任務重啟和資源重調度,確保長時間訓練在處理芯片失效時不中斷任務。
- 綠色計算與能效管理:在調度算法和運行時層面不僅關注性能,也對集群功耗進行統一管控。
四、
以智能芯片構建的人工智能計算機集群提供物理世界的算力基座,而人工智能基礎軟件開發則決定了這片基座上能夠生長出怎樣的巨人模型和應用的大廈。從芯片架構到系統軟件,從編程框架到工具鏈,每一層的演進都在推動AI技術更多地走向超級尺度并更具經濟性。未來的核心突破,將越來越多地來自軟硬件深度協同的系統級創新。